반응형

 자바로 백엔드 개발을 하기 위해서는 스프링 프레임워크가 거의 필수라고 볼 수 있다. 

자바로 개발을 해보았다고 해도 스프링의 진입장벽은 높기 때문에 이러한 진입장벽을 그나마 낮춰주는 스프링부트가 존재한다.

(.. 그래서 스프링을 처음 공부하기 위해 스프링부트부터 선택하였다. 스프링 공부 서적으로 유명한 토비의 스프링 책만 보아도 스프링은 Top-down 으로 가야 할것 같다. )


스프링 프레임워크 란


 스프링부트를 알기 위해서는 스프링 프레임워크부터 알아야한다. 

스프링 프레임워크(이하 스프링)는 자바 기반 엔터프라이즈 애플리케이션 개발을 위한 포괄적인 인프라를 제공해주는 플랫폼이다. 

스프링은 오픈소스 기반이며 쉽게 설명하면 엔터프라이즈 애플리케이션 개발을 편리하게 해주는 도구라고 생각하면 된다.

라이센스는 아파치 2.0 이다. ( .. 이게 스프링이 필수인 주요한 이유가 아닌가 싶다. )


엔터프라이즈 애플리케이션 이란
엔터프라이즈 애플리케이션은 이름 그대로 기업형 프로그램으로 자바에서는 JavaEE (Java Enterprise Edition)을 통해 개발되었다.
JaveEE 는 JavaSE(Java Standard Edition)에 서버측 개발을 위한 기능이 더해진 자바 버전이라고 보면 된다.
스프링은 이런 JaveEE를 대체하기 위해 개발되었기 때문에 엔터프라이즈 애플리케이션 개발을 위한 플랫폼이라고 설명한다.


스프링의 역사


스프링은 2002년 로드 존슨이 최초로 개발하였다.

왜?

자바로 엔터프라이즈 애플리케이션을 개발하기 위해서 JavaEE가 사용되었는데 JavaEE에서 핵심적인 역할을 하는 것이 EJB 이다.

EJB는 엔터프라이즈 애플리케이션을 쉽게 작성할 수 있도록하는 목표를 가지고 있었지만 개발자들에게 EJB는 생각 보다 쉽지 않았다.

예를들어 소스코드 측면에서 EJB 관련 클래스를 반드시 사용해야 한다거나, 개발환경 측면에서 EJB 컨테이너를 사용해야 한다는 제약은 개발 생산성과 유지 보수성 저하와 테스트와 배포의 어려움을 가져왔다. 

이러한 문제점들을 해결하고 엔터프라이즈 애플리케이션 개발을 더 쉽게 하기 위해 스프링이 탄생하였다.


EJB(Enterprise Java Beans) 란
EJB는 기업환경의 시스템을 구현하기 위한 서버측 컴포넌트 모델


스프링은 2004년 1.0 버전 출시 이후 계속 버전이 업데이트 되면서 2019년(현재 기준) 5.1 버전대 까지 등장하였다.


스프링의 특징


스프링의 특징은 하나하나 중요한 개념이고 가볍지 않은 내용이라 해당 특징들은 차차 공부하면서 알아가는게 좋을 것 같다. ( ..처음부터 이해도 되지 않을 뿐더러 지친다. )

처음엔 대략적으로 이런것들이 있구나만 알고 넘어가자.
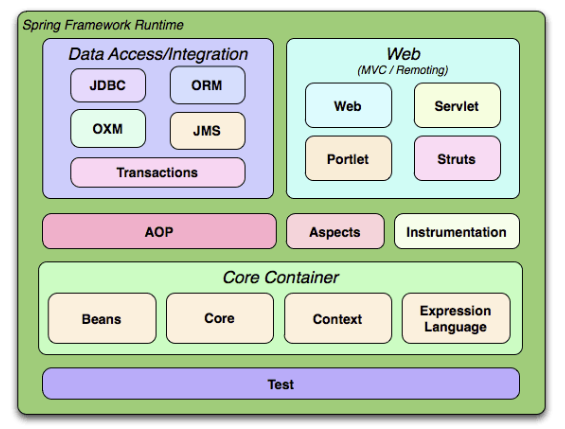
 

스프링 구조


핵심 기술 

  • POJO (Plain Old Java Object)

  • DI (Dependency Injection)

  • IoC (Inversion of Control)

  • AOP (Aspect Oriented Programming)

  • PSA (Potable Service Abstraction)


테스팅

  • mock objects

  • TestContext framework

  • Spring MVC Test

  • WebTestClient


통합

  • remoting

  • JMS

  • JCA

  • JMX

  • email

  • tasks

  • scheduling

  • cache


데이터 엑세스

  • transactions

  • DAO support

  • JDBC

  • ORM

  • Marshaling XML


스프링MVC 와 스프링WebFlux


언어 (자바 이외 지원 언어)

  • Kotlin

  • Groovy

  • dynamic language 


스프링부트 란


 스프링부트를 알기위해 돌고 돌아 스프링부터 간략하게 살펴보았는데 드디어 스프링부트란 무엇인가 말할 수 있다!  스프링부트는 실행만 하면 스프링 기반의 상용화가 가능한  애플리케이션을 쉽게 만들기 위해 단독 실행을 가능하게 해주는 스프링 프로젝트이다.

즉, 스프링부트는 스프링을 쉽게 사용할 수 있도록 필요한 설정을 대부분 미리 세팅 해놓았다는 뜻이다.

스프링부트는 2019년(현재 기준) 2.1.7 버전 까지 나와있다.


스프링부트의 특징


  • 단독으로 실행이 가능한 스프링 애플리케이션을 생성함

  • Tomcat, Jetty, Undertow 를 내장

  • 기본설정이 되어있는 starter 컴포넌트를 제공

  • 가능한 자동으로 설정되어 있음

  • 상용화에 필요한 통계, 상태 체크, 외부 설정 등을 제공

  • 설정을 위한 XML 코드를 생성하거나 요구하지 않음


* 해당 포스팅은 https://spring.io/ 을 기준으로 하고 있습니다.


반응형
반응형

나름 디자인을 입혀보겠다고 구글의 Marterial Card 를 사용했는데 빌드만하면 XML 파일 에러를 띄우며 앱이 죽는다.
gradle 에 의존성 추가도 해주고 Marterial-Card-View 레퍼런스를 참고하여 옵션을 넣었는데도 아래와 같은 에러가 발생하였다.


Caused by: java.lang.IllegalArgumentException: The style on this component requires your app theme to be Theme.MaterialComponents (or a descendant). 


에러 메시지는 app theme 이 필요하다는데..

그게 무슨말이야! 하고  Getting started 를 살펴보니 에초에 Material 을 사용하기 위한 기본 세팅을 제대로 안해준 것이다..

(레퍼런스를 처음부터 차근차근 읽어보지 않았던 탓... )


원인 : Marterial Design 을 사용하기 위해서는 액티비티에 Material Components Themes 을 style 로 지정해 주지 않아서 발생 


해결책 : AndroidManifest.xml 에서 Material Design 을 사용할 액티비티에 Material Components Themes 중 하나를 선택하여 옵션으로 넣어주면 된다.


<activity android:name=".SampleActivity"
android:theme="@style/Theme.MaterialComponents.Light.NoActionBar.Bridge"/>


참고로 Material Components Themes 의 종류는 다음과 같다. 

  • Theme.MaterialComponents

  • Theme.MaterialComponents.NoActionBar

  • Theme.MaterialComponents.Light

  • Theme.MaterialComponents.Light.NoActionBar

  • Theme.MaterialComponents.Light.DarkActionBar

  • Theme.MaterialComponents.DayNight

  • Theme.MaterialComponents.DayNight.NoActionBar

  • Theme.MaterialComponents.DayNight.DarkActionBar

이 중 하나를 선택해서 넣어주면 되고, 여기서 원하는 옵션이 없으면 styles.xml 에서 AppTheme 을 수정하거나 새로 Theme 을 만들어서 액티비티 옵션에 넣어줘도 된다.( Getting Started 에 설명이 잘 나와있다. )


* 해당 포스팅은 Material Design : Android 를 기준으로 하고 있습니다.


반응형
반응형


ubuntu 에서 apt-get update 를 하고 나서 apt-get upgrade 및 install 시에 다음과 같은 에러가 발생한다.


E: Could not get lock /var/lib/dpkg/lock - open (11: Resource temporarily unavailable)
E: Unable to lock the administration directory (/var/lib/dpkg/), is another process using it?


에러 메세지를 읽어보면 /var/lib/dpkg/ 디렉토리를 다른 프로세스에서 사용 중이라 충돌이 일어난다는 것 같다.

아마 apt-get ~ 프로세스를 사용하던 중 제대로 종료되지 않아서 그런 것 같다. 

그러면 apt-get 에 걸려있는 프로세스가 있는지 확인하고 종료해 주자.


원인 

apt-get 프로세스 충돌


해결책 

1. 실행 중인 apt 관련 프로세스 찾기


ps aux | grep -i apt 

----- 결과 화면 -----

root      1852  0.0  5.0 110268 24772 ?        S    Aug04   4:13 apt-get upgrade

root     21461  0.0  0.2  14856  1156 pts/2    S+   04:32   0:00 grep --color=auto -i apt

-------------------

결과 화면을 보면 프로세스 아이디가 1852인 apt-get upgrade 프로세스가 실행 중이다. 
그 아래에 있는 프로세스는 신경쓰지 않아도 된다.


2. 실행 중인 apt 프로세스 종료


sudo kill -9 <process id>


위의 경우에서는 sudo kill -9 1852 라고 해주면 된다.

( 간편한 방법으로는 그냥 처음부터 sudo killall apt apt-get 도 있다.)


참고

만약에 위의 방법으로도 에러가 해결되지 않으면 다음과 같이 해결 하면 된다.


rm /var/lib/dpkg/lock
rm /var/lib/apt/lists/lock
rm /var/cache/apt/archives/lock
dpkg --configure -a


lock 파일이 패키지 및 인덱스 정보를 업데이트하지 않아서 문제가 발생할 수 있기 때문에 해당 파일들을 삭제해주고 dpkg 를 설정해주면 된다. lock 파일은 호스팅 서버에 설치된 이미지에 세팅되어 있는 경우가 많다고 한다.


* 해당 포스팅은 ubuntu 18.04 를 기준으로 하고 있습니다.


반응형
반응형

안드로이드 스튜디오를 간만에 업데이트(3.4.2 버전)하고 새 프로젝트를 생성하고 빌드하다 보니 다음과 같은 에러가 발생하였다.


 Error: Invoke-customs are only supported starting with Android O (--min-api 26) 


무슨 에러인가 보았더니 역시나 친절한 안드로이드 스튜디오는 알려준다.


AGPBI: {"kind":"error","text":"Invoke-customs are only supported starting with Android O (--min-api 26)","sources":[{}],"tool":"D8"}
> Task :app:mergeExtDexDebug FAILED
FAILURE: Build failed with an exception.
* What went wrong:
Execution failed for task ':app:mergeExtDexDebug'.
> Could not resolve all files for configuration ':app:debugRuntimeClasspath'.
   > Failed to transform artifact 'material.aar (com.google.android.material:material:1.1.0-alpha08)' to match attributes {artifactType=android-dex, dexing-is-debuggable=true, dexing-min-sdk=24}
      > Execution failed for DexingTransform: /Users/noah/.gradle/caches/transforms-2/files-2.1/37a0daf16d8ba7dc17296903cb0a1c4f/jars/classes.jar.
         > Error while dexing.
           The dependency contains Java 8 bytecode. Please enable desugaring by adding the following to build.gradle
           android {
               compileOptions {
                   sourceCompatibility 1.8
                   targetCompatibility 1.8
               }
           }
           See https://developer.android.com/studio/write/java8-support.html for details. Alternatively, increase the minSdkVersion to 26 or above.


고맙게도 해결방법까지 알려준다.

프로젝트를 생성할 때 이번에 변경된 안드로이드x 패키지를 사용하였는데 라이브러리 중에서 자바8 (JDK 8) 언어의 바이트코드를 의존성으로 가지고 있어 컴파일 옵션추가가 필요하다는 것 같다. ( Dex 쪽 문제인듯 싶다. )


원인 : 라이브러리의 JDK 버전 호환 문제


해결책 : 프로젝트 gradle 에서 android { ~ } 안에 다음과 같은 옵션 추가

compileOptions {
sourceCompatibility 1.8
targetCompatibility 1.8
}


반응형
반응형

 데이터베이스 설계는 시스템 개발을 하기 위해 필수적이기 때문에 데이터베이스 설계가 어떻게 이루어지는지 알 필요가 있다.

데이터베이스 설계는 데이터 중복이 없어야 하며 필요한 데이터에 대한 정확한 분석이 필요하다.

데이터베이스가 제대로 설계되지 않으면 추후 확장이나 유지보수가 굉장히 어렵고, 설계를 바꾸는 작업도 비용이 많이 든다.

( ..데이터베이스 설계가 프로젝트의 백년대계를 좌지우지 한다고 해도 과장이 아니다. )


데이터베이스 설계 프로세스


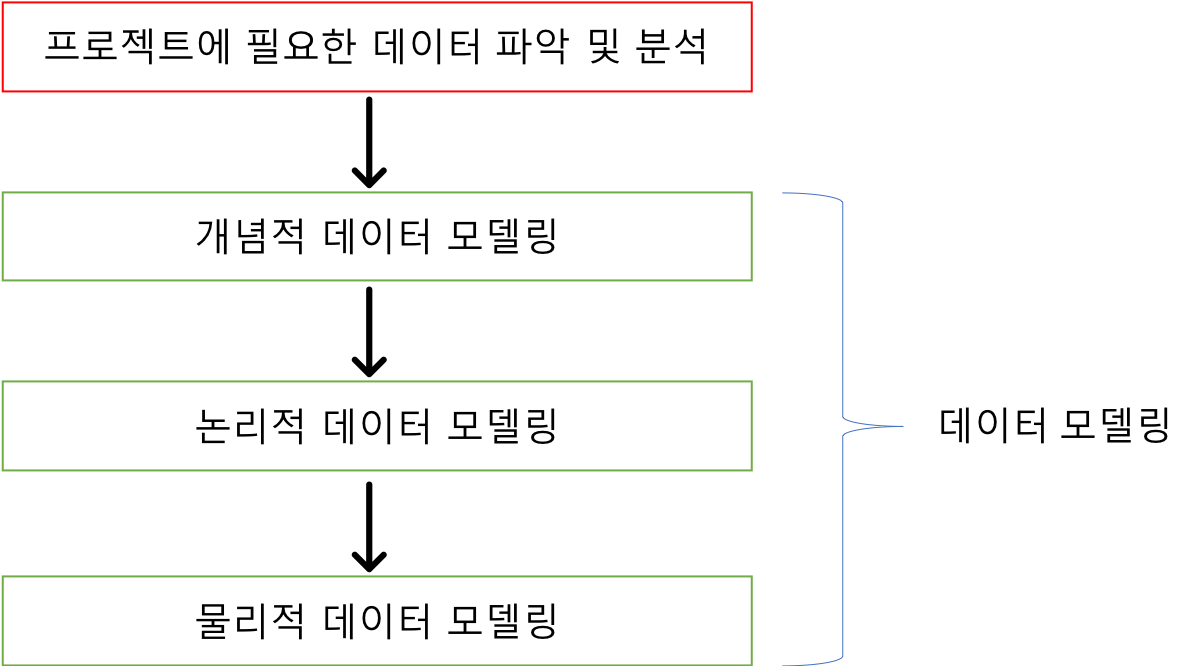
 데이터베이스 설계 프로세스를 살펴보면 가장 우선적으로 해야할 일은 프로젝트에 필요한 데이터를 파악하고 분석하는 일이다. 

실제로 프로젝트를 진행하다 보면 데이터베이스 설계 자체 문제 보다는 프로젝트에 필요한 데이터에 대한 정의나 파악부터 미흡해서 어려움을 겪는 일이 많기 때문이다. 

데이터에 대한 파악과 분석이 끝나면 아래의 그림과 같은 순서로 데이터 모델링을 진행된다. 


< 데이터베이스 설계 프로세스 >


데이터 모델링이란


 데이터 모델링이란 현실 세계의 어떠한 개념을 컴퓨터의 데이터베이스로 옮기는 변환 과정을 의미한다. 

이러한 데이터 모델링을 과정에 따라 개념적, 논리적, 물리적 데이터 모델링으로 구분한다. 


  • 개념적 데이터 모델링 

    : 개념적 데이터 모델링은 데이터들의 구조도를 그리는 과정이다. 개념적 데이터 모델링을 할 때에는 개체-관계 모델(E-R Model, Entity-Relationship Model)을 많이 사용한다.

  • 논리적 데이터 모델링

    : 논리적 데이터 모델링은 데이터 모델을 선택하고 데이터 스키마를 결정하는 과정이다. 이 과정에서 관계 데이터 모델을 가장 많이 사용한다.

  • 물리적 데이터 모델링

    : 물리적 데이터 모델링은 논리적 데이터 모델링에서 선택한 데이터베이스 모델에 따라 데이터베이스 관리 시스템(DBMS)으로 물리적인 데이터베이스를 만들어내는 과정이다. 


데이터 모델링 과정이 이름은 어렵게 구분해 놓았지만 단순하게 따져보면 데이터들의 관계를 구조화시켜서 그려보고, 어떤 데이터베이스 모델을 선택할지 결정해서 데이터를 어떤 형식(데이터 타입)으로 저장하고 어떤 제약조건을 적용할지 정한 다음 DBMS로 구현하는 것이다. 

더 구체적으로 데이터 모델을 적용해서 설명하자면 개체-관계 모델을 이용하여 필요한 데이터들의 구조도를 그려보고, 관계 데이터베이스 모델에 따라 스키마를 결정하면 된다. 그리고 MySQL 같은 자신이 선택한 RDBMS 로 데이터베이스를 구축하면 된다.


개체-관계 모델이란


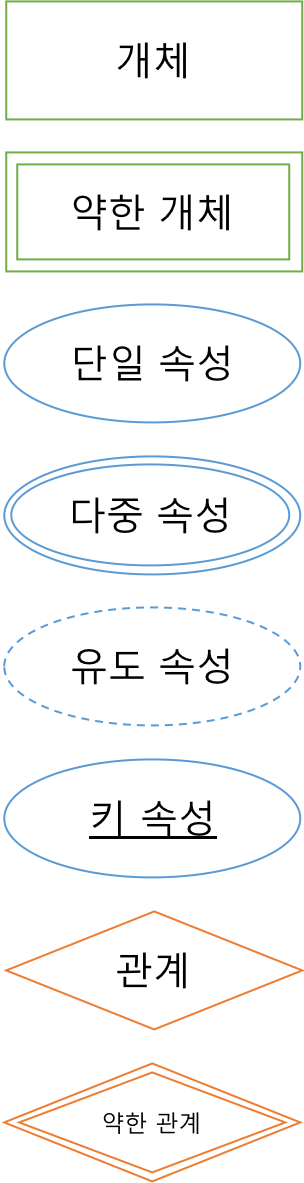
 개체-관계 모델은 피터 첸(Peter Chen)이란 컴퓨터 박사가 1976년에 제안한 것으로, 개체-관계 다이어그램 (E-R 다이어그램)이라고도 한다. E-R 다이어그램은 데이터를 개념적으로 모델링한 결과물을 그림으로 표현하는 방법론으로 구성은 개체, 속성, 관계로 이루어져있다.

사각형, 마름모, 타원, 선 등을 이용하여 개체들의 일대일(1:1), 일대다(1:n), 다대다(n:m) 관계를 그림으로 표현한다. 

사각형은 개체, 마름모는 개체 간의 관계, 타원은 개체나 관계의 속성을 나타낸다. 연결선(링크)는 각 요소를 연결하는 역할을 한다.

< ER 다이어그램 구성 요소 >


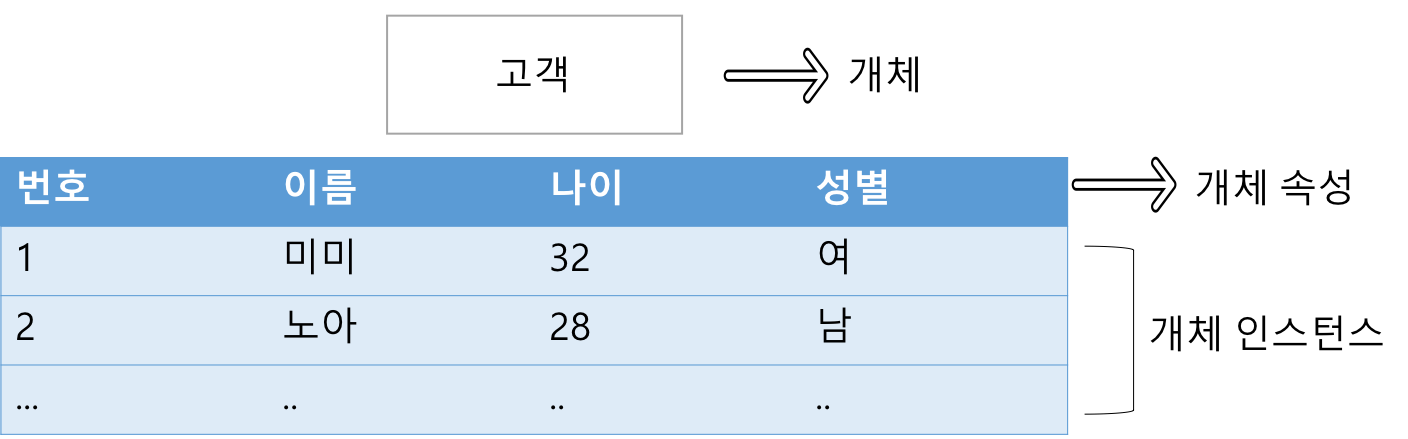
  • 개체 (entity) : 독립된 하나의 개념적 존재로 RDBMS 에서는 하나의 테이블이라 생각하면 된다.

< 개체 >


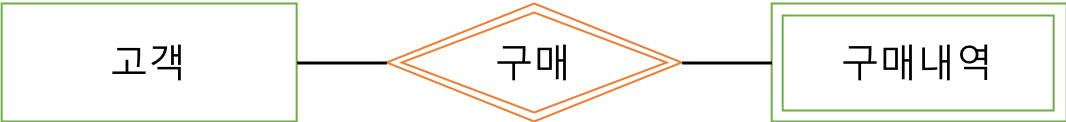
  • 약한 개체(weak entity) : 두 개체가 있을 때 독자적으로 존재할 수 없고, 종속되는 개체를 약한 개체라고 한다. 예를들어 고객과 구매내역이라는 개체가 있으면 두 개체는 구매라는 관계로 이어지고, 구매내역은 고객이라는 개체가 없으면 의미가 없는 것이기 때문에 고객 개체에 종속된다. 여기서 고객을 오너개체, 구매내역을 약한 개체라고 부른다. 일반적으로 오너 개체와 약한 개체는 일대다(1:n)의 관계를 가진다. ( 오너 개체와 약한 개체가 맺는 관계는 이중 마름모로 표현한다. )

< 약한 개체 >


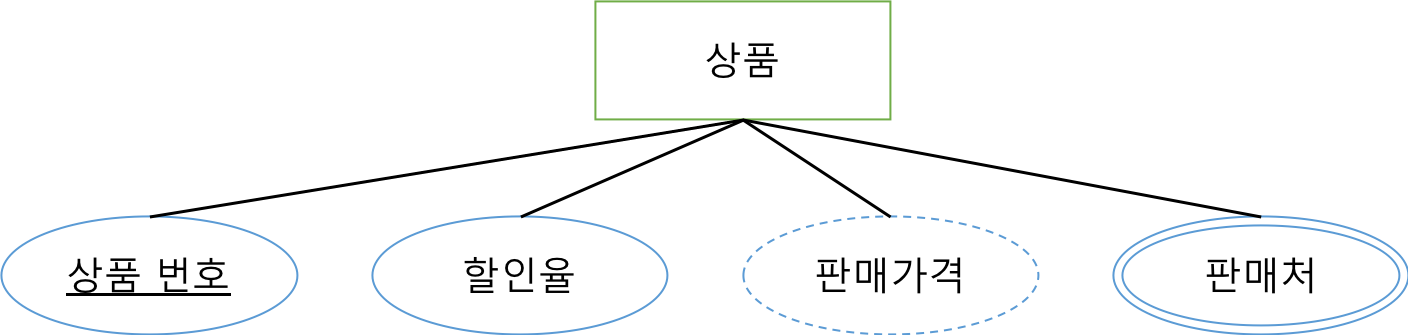
  • 속성(attribute) : 속성은 개체가 가지고 있는 고유의 특성이다. 속성들이 모여 하나의 개체가 된다. RDBMS에서는 레코드 부분이라 생각하면 된다. 속성에도 종류가 있는데 아래의 그림과 같이 상품 번호처럼 밑줄 그어진 속성은 키 속성으로 개체의 각 인스턴스를 식별하는 역할을 한다. 할인율 같은 경우는 단일 속성으로 하나의 값을 가지는 일반적인 속성이다. 판매가격 같은 경우는 다른 속성의 값에 따라 값이 유도되어 결정된다고 하여 유도 속성이라 한다. 판매처의 경우 다중 값 속성이라 하여 값이 여러개가 존재할 수 있는 속성이다. 상품마다 판매처는 여러 곳일 수 있기 때문에 다중 값 속성이 되는 것이다.

< 속성 >


  • 관계(relationship) : 관계는 각각의 개체의 인스턴스들이 맺는 관계 유형에 따라 일대일(1:1), 일대다(1:n), 다대다(n:m) 으로 나누어진다.

< 일대일(1:1) 관계 >
< 일대다(1:N) 관계 >


< 다대다(N:M) 관계 >


 이 외에도 E-R 다이어그램으로 표현 가능한 다양한 방법들이 있다. 자신의 목적에 맞게 사용하면 되겠다.


관계 데이터 모델


 논리적 데이터 모델링에서 사용되는 관계 데이터 모델은 하나의 개체에 대한 데이터를 릴레이션(테이블) 하나에 담아 데이터베이스에 저장한다. 계층형, 네트워크형에 비해 개체 간 관계 표현이나 데이터 검색, 삽입, 삭제, 수정 등 데이터 연산에 더 유리하고 이해하기 쉬워 관계 데이터 모델을 가장 많이 사용한다. 논리적 데이터 모델링에서는 관계 데이터 모델에 맞게 릴레이션을 정의하고 각 속성에 맞는 스키마를 지정하는 작업을 하게 된다.

( ..E-R 다이어그램을 관계 데이터 모델로 옮기는 작업이다 생각하자. )


1. 관계 데이터 모델 용어 정리

  • 속성 : 열 또는 어트리뷰트(attribute) 라고 부르며, 테이블에서 필드에 해당하는 부분이다. 속성은 서로 다른 이름을 붙여서 구분한다.

  • 튜플 : 릴레이션(테이블)의 행을 튜플(tuple)이라고 한다. 개체의 인스턴스를 의미하며, 테이블에서 레코드에 해당하는 부분이다.

  • 도메인 : 속성 하나가 가질 수 있는 값의 모음을 의미한다. RDBMS에서는 데이터 타입을 생각하면 된다.

  • 널 값 : 널(null) 값은 특정 속성에 해당 값이 없는 경우를 나타낸다. ( 숫자 0 or 공백은 그 자체를 값으로 보기 때문에 null 이 아니다. )

  • 차수 : 하나의 릴레이션(테이블)에서 속성의 전체 개수를 릴레이션의 차수(degree)라고 한다. 테이블에서 필드의 개수라고 생각하면 된다.

  • 카디널리티 : 카디널리티(cardinality) 는 하나의 릴레이션에서 투플의 전체 개수를 의미한다. 즉 하나의 테이블의 레코드수( 데이터 수) 라고 보면 된다.

2. 릴레이션(테이블)의 특성

  • 튜플의 유일성 : 하나의 릴레이션에는 동일한 튜플이 존재할 수 없다는 뜻이다. 즉, 테이블에서 레코드가 중복되지 않는다는 의미인데 이러한 특성을 만족시키기 위해서 키(key) 라고 부르는 값의 중복이 불가능한 속성을 넣는다.

  • 튜플의 무의미한 순서 : 릴레이션에서 튜플의 순서는 무의미하다는 뜻이다. RDBMS는 사람이 알아보기 쉽게 테이블 형태로 순차적으로 데이터를 담아 보여주지만 데이터들의 순서는 사실 상관없다. 데이터베이스는 위치가 아닌 내용으로 검색되기 때문이다.

  • 속성의 무의미한 순서 : 릴레이션에서 속성의 순서 또한 의미가 없다는 뜻이다. 튜플과 마찬가지로 사람이 알아보기 쉽게 지정한 속성을 순서대로 보여주지만 데이터베이스에서는 상관없는 부분이다. 데이터베이스에서는 속성도 위치가 아닌 속성의 이름으로 속성을 구별하기 때문이다. 따라서 속성의 이름을 어떻게 짓느냐가 더 중요할 수 있다.

  • 속성의 원자성 : 속성의 원자성이라는 특성은 속성의 값은 하나의 값(원자 값)만 가질 수 있다는 뜻이다.

3. 키(key)

 키는 관계 데이터 모델에서 제약조건을 정의한다. 

  • 슈퍼키(super key) : 슈퍼키는 유일성을 만족하는 속성을 의미한다. 유일성이라는 것은 키 값이 유니크(unique)하다는 것이며 유일성은 키가 갖추어야 하는 기본 특성이다. 쉽게 설명하자면 키가 되는 속성의 값에는 중복이 없다는 것이다.

  • 후보키(candidate key) : 후보키는 유일성과 최소성을 만족하는 속성이다. 최소성은 해당 키 속성이 없으면 튜플을 구별할 수 없는 꼭 필요한 속성을 의미한다. 여러 속성이 키로 지정될 수 있기 때문에 슈퍼키 중에서도 단독으로 튜플을 구별할 수 있는 속성들만 후보키가 될 수 있다.

  • 기본키(primary key) : 기본키는 후보키 중에 기본적으로 사용할 키로 선택한 속성을 의미한다. 널(null) 값을 가질 수 있는 속성은 기본키로 부적합하고, 값이 변경될 가능성이 적은 후보키가 기본키로 적합하다. 예를들어 아이디값이나, 회원번호 같은 값들이 기본키로 적합하다 볼 수 있다.

  • 대체키(alternate key) : 대체키는 기본키로 선택되지 못한 후보키들이다. 

  • 외래키(foreign key) : 외래키는 다른 릴레이션의 기본키를 참조하는 속성이다. 외래키는 관계 데이터 모델에서 관계를 이어주는 핵심이라고 볼 수 있는데, 다른 릴레이션의 기본키 값을 참조하여 릴레이션을 서로 이어준다. 쉽게 생각하면 테이블끼리 이어주는 값이라 보면 되고, 외래키는 다른말로 참조키라고 하는데 이름 그대로 참조하는 기본키의 값 내에서 값을 가져야한다. (참조할 수 없는 값은 가질 수 없다.) 외래키는 기본키를 참조하기 때문에 중복 값을 가질 수 있고, 기본키의 값 내에서 값을 가져야 한다고 했지만 예외로 널(null) 값은 가질 수도 있다. 


4. 관계 데이터 모델의 제약 조건

 관계 데이터 모델을 사용할 때 지켜야하는 조건을 관계 데이터 모델의 제약조건이라고 한다. 개체 무결성 제약조건과 참조 무결성 제약조건이 있는데 각각 기본키와 외래키에 관한 제약조건이다. 이 조건들은 데이터를 정확하고 유효하게 유지하기 위해 지켜야하는 조건이다.


  • 개체 무결성 제약조건 : 기본키를 구성하는 모든 속성은 널(null) 값을 가질 수 없다.

  • 참조 무결성 제약조건 : 외래키는 참조할 수 없는 값을 가질 수 없다. ( 다만, 널(null) 값은 예외로 참조 무결성 제약조건을 위반한 것으로 보지 않는다.)


반응형
반응형

 데이터베이스에 대해 정리하면서 데이터베이스 관리 시스템에 대해서도 정리하기는 했지만 DBMS의 내부 구성이 어떤지 어떻게 작동하는지에 대해서도 알아둘 필요가 있다. 


2019/06/07 - [IT 정보 로그캣/데이터베이스] - [데이터 베이스] 데이터베이스란 ?


[데이터 베이스] 데이터베이스란 ?

우리는 자료와 정보라는 말을 많이 사용한다. 보통 두 단어를 혼동해서 많이 사용하는데 엄밀히 따지자면 각각 정의가 다르다. 자료(Data) 는 숫자, 영상, 단어 등의 형태로 된 의미 단위로 날것(raw)에 가깝다...

noahlogs.tistory.com


데이터 언어


 데이터베이스 관리 시스템의 구성을 이해하기 위해 데이터 언어부터 살펴보자.  

데이터베이스 관리 시스템을 사용하기 위해서는 데이터 언어(Data Language)를 사용해야한다.

보통은 데이터 언어라고하면 SQL을 의미한다고 생각하면 되는데 이러한 데이터 언어도 기능에 따라 개념이 나뉘어진다.

  • 데이터 정의어(DDL, Data Definition Language) : 스키마를 정의하거나, 수정 또는 삭제하기 위해 사용하는 언어. 데이터 정의어로 정의된 스키마는 데이터 사전에 저장되고, 삭제나 수정이 발생하면 이 내용도 데이터 사전에 반영된다. Create, Alter, Drop 등이 있다.

  • 데이터 조작어(DML, Data Manipulation Language) : 데이터의 삽입, 삭제, 수정, 검색 등의 처리를 요구하기 위해 사용하는 언어. Select, Insert, Delete, Update 등이 있다.

  • 데이터 제어어(DCL, Data Control Language) : 내부적으로 필요한 규칙이나 기법을 정의하기 위해 사용하는 언어. Commit, Rollback, Grant, Revoke 등이 있다. 

스키마(schema)란
스키마는 데이터베이스에 저장되는 데이터 구조와 제약조건을 정하는 것을 의미한다. 
예를들어 데이터베이스는 데이터에 INT, CHAR 등의 데이터 타입을 지정한다거나, 중복된 값을 허용하지 않는 등의 제약조건을 지정할 수 있다.


데이터베이스 관리 시스템의 구성


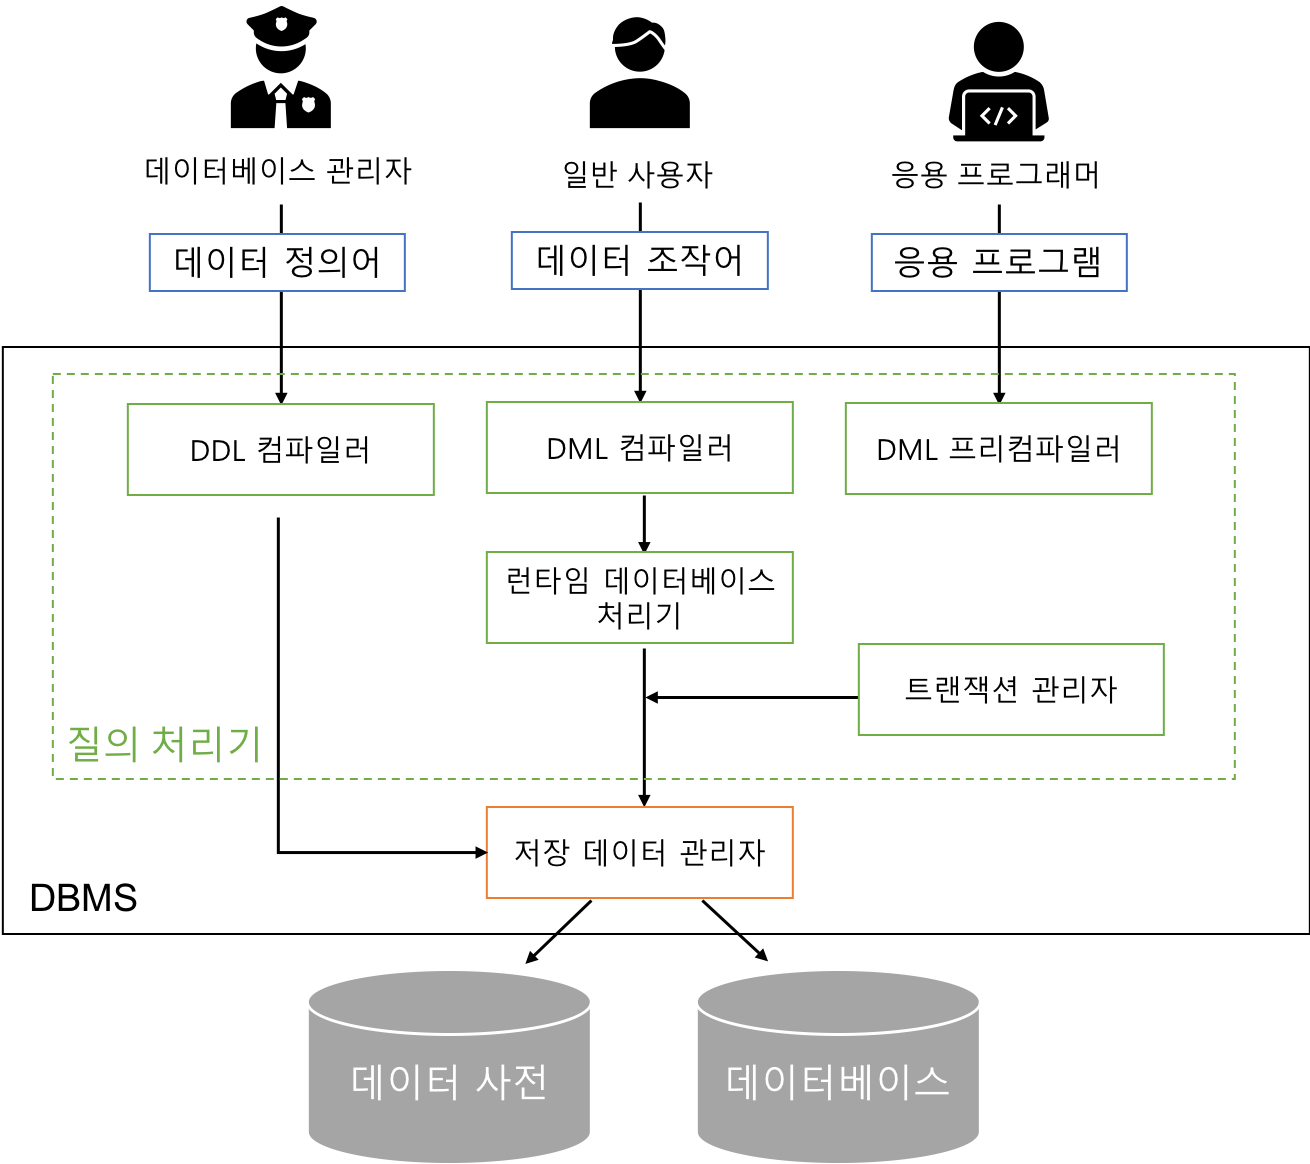
 데이터베이스 관리 시스템은 기능에 따라 크게 질의 처리기와 저장 데이터 관리자로 구성되어 있다.


< DBMS 구성 >


질의 처리기(Query Processor)


 질의 처리기는 사용자의 데이터 처리 요구를 해석하여 처리하는 역할을 한다. 


  • DDL 컴파일러(DDL compiler) : 데이터 정의어로 작성된 스키마를 해석한다. 데이터베이스를 생성하거나, 스키마의 정의를 데이터 사전에 저장한다.

  • DML 프리컴파일러(DML precompiler) : 응용 프로그램에 삽입된 데이터 조작어를 추출하여 DML 컴파일러에  전달한다.

  • DML 컴파일러 (DML compiler) : 데이터 조작어 (삽입, 삭제, 수정, 검색) 요청을 분석하여 런타임 데이터베이스 처리기가 이해할 수 있도록 해석한다.

  • 런타임 데이터베이스 처리기 (run-time database processor) : 저장 데이터 관리자를 통해 데이터베이스 접근하여 DML 컴파일러로 부터 전달받은 요청을 데이터베이스에서 실제로 실행한다.

  • 트랜잭션 관리자(transaction manager) : 데이터베이스에 접근하는 과정에서 사용자의 접근 권한이 유효한지 검사하고, 데이터베이스 무결성을 유지하기 위한 제약조건 위반 여부를 확인한다. 회복이나 병행 수행과 관련된 작업도 한다.


컴파일러(compiler)란
컴파일러는 특정 프로그래밍 언어로 쓰여 있는 문서를 다른 프로그래밍 언어로 옮기는 프로그램을 말한다. 컴파일러가 우리가 작성한 고급 프로그래밍 언어는 컴퓨터가 이해할 수 있는 언어(기계어)로 변환해주어야 실행된다.
DBMS 에서도 마찬가지로 사용자가 작성한 데이터 언어가 수행될 수 있도록 컴파일러가 변환해주는 것이다.


저장 데이터 관리자(stored data manager)


 저장 데이터 관리자는 디스크에 저장되어 있는 사용자 데이터베이스와 데이터 사전을 관리하고, 접근한다. 

하지만 디스크에 저장된 데이터에 접근하는 것은 운영체제의 기본 기능이므로 저장 데이터 관리자는 운영체제의 도움을 받아 데이터베이스에 대한 접근을 수행한다.


데이터 사전(data dictionary)란
 데이터 사전이란 시스템 카탈로그(system catalog)라고도 한다. 데이터 사전은 데이터베이스에 저장되는 데이터에 관한 정보를 저장한다.
데이터에 대한 정보를 의미하기 때문에 메타 데이터라고도 한다. 데이터 사전도 그냥 하나의 데이터베이스라고 생각하면 된다.


반응형
반응형

 HTTP 에는 쿠키라는 개념이 존재하는데, 이름부터가 친숙하고 귀엽다. 

왜 쿠키라는 이름이 붙여졌을까에는 여러가지 이야기들이 있는데, 내가 처음 공부할 때 들었던 이야기는 헨젤과 그레텔 동화에서 쿠키라는 이름이 유래했다는 것이다. 동화에서 헨젤과 그레텔이 자신들이 지나온 길을 표시하기 위해 쿠키조각을 바닥에 떨어뜨린 것과 마찬가지로 서버에 요청한 사람이 누구인지 표시하기 위해 클라이언트에 쿠키를 남긴다해서 쿠키라 부른다는 것이다. ( ..그럴싸 하다.)

또 다른 이야기로는 쿠키 안에 운세 같은 메세지가 담겨있는 포춘쿠키와 유사하다고 해서 쿠키가 되었다라는 이야기도 있다.

하지만 사실은 유닉스 운영체제에서 두 프로그램 사이에 전송되는 작은 데이터 패킷을 매직 쿠키라 불렀는데 여기서 HTTP 쿠키가 유래되었다. HTTP 쿠키를 만든 루 몬텔루 라는 웹 브라우저 개발자가 사용자들의 방문 기록을 남기기 위해 매직 쿠키에서 개념을 차용해서 사용한 것이다.

(.. 출처는 구글질문 에서 찾았는데 루 몬텔루에게 직접 확인된 사실이라 한다. 물론 위키백과에도 나와있다. 위에 언급된 이야기들은 아마 매직쿠키의 유래가 아닌가 싶다. )


HTTP 쿠키( Cookie) 란


 HTTP 쿠키는 웹 쿠키, 브라우저 쿠키로도 불리는데 서버가 사용자의 웹 브라우저에 전송하는 작은 데이터 조각을 의미한다.

위에서 언급했듯이 유닉스의 매직쿠키에서 이름과 개념이 유래하였고, 루 몬텔루라는 웹 브라우저 개발자가 웹 사이트에 접속한 클라이언트를 확인하기 위해 만들었다. HTTP 통신은 stateless 하기 때문에 클라이언트를 확인하기 위해서는 쿠키라는 개념이 따로 필요했기 때문이다.

쿠키는 주로 세션 관리( 서버에서 관리하는 로그인 등의 정보를 의미한다. ), 개인 설정유지, 사용자 트래킹( 사용자의 행동을 기록하고 분석하는 것 ) 용도로 사용된다.

HTTP의 stateless 란
statsless 라는 것은 번역하자면 상태가 없다는 뜻이다. HTTP에서 stateless 하다는건 서버 입장에서 클라이언트의 상태가 없다는 의미로 동일한 클라이언트의 요청이라도 매번 각 요청은 독립적이라는 의미이다. 예를들어 놀이공원(서버)에서 손님이 입장(요청)했다가 퇴장(응답)했을 때 손님들을 한명 한명 다 기억할수가 없다. 그렇기 떄문에 놀이공원에서는 재입장하는 손님을 구분하기 위해 팔찌같은 입장권을 준다.
마찬가지로 서버에서도 이미 요청을 했었던 클라이언트인지 매번 확인하기 어렵기 때문에 입장권처럼 쿠키를 주는 것이다.


HTTP 쿠키의 특징

  • 쿠키는 한개에 4KB 까지 저장 가능하며, 최대 300개 까지 저장할 수 있는 텍스트 파일이다.

  • 쿠키는 클라이언트에 저장된다.

  • 쿠키에는 이름, 값, 만료날짜, 경로 정보가 들어있다.

  • 기본적으로 쿠키는 웹 브라우저가 종료되면 삭제된다. ( 만료날짜를 지정해 주면 만료일이 되야 삭제된다.)

  • 웹 브라우저에 해당 서버의 쿠키 정보가 있으면 HTTP 요청 (HTTP 헤더의 Cookie)에 무조건 담아 보낸다.


HTTP 쿠키 작동방식


 쿠키도 결국 HTTP 통신에서 이루어지는 것이기 때문에 HTTP 의 응답과 요청에 따라 작동한다.

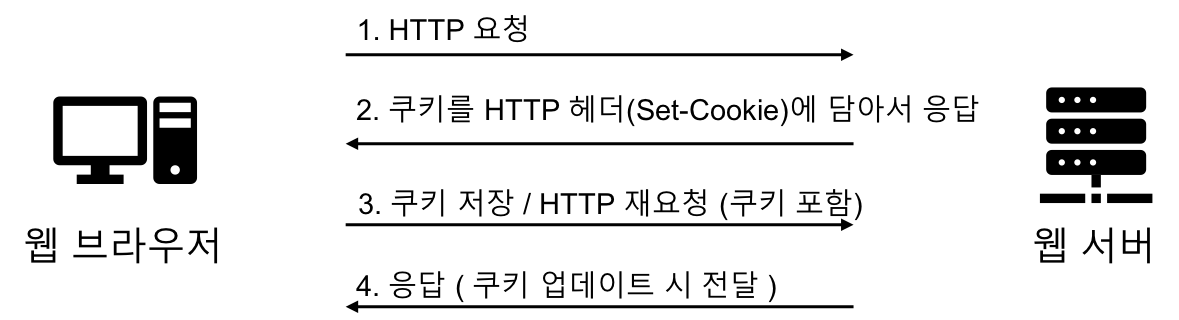
요청을 받은 서버에서 쿠키를 클라이언트(웹 브라우저)로 보내고 클라이언트는 쿠키를 받으면 도메인 서버 이름으로 정렬된 쿠키 디렉토리에 쿠키(정보)를 저장한다. 이후 클라이언트가 동일한 서버로 HTTP 요청을 보내면 저장된 쿠키도 같이 전송되며, 만약 서버에서 쿠키에 업데이트된 내용이 있으면 응답할 때 다시 업데이트된 쿠키를 보내준다.


< 쿠키 작동순서 >


HTTP 세션(seesion) 이란


 세션이란 통신을 하기 위해 서로 연결된 순간부터 통신을 마칠 때 까지의 기간을 의미한다.

단순히 session 의 뜻을 찾아보아도 시간, 시즌 이라고 나온다.

HTTP 세션이란 클라이이언트가 웹서버에 연결된 순간부터 웹 브라우저를 닫아 서버와의 HTTP 통신을 끝낼 때 까지의 기간이다.

하지만 보통 세션이라고 말할 때에는 서버에 세션에 대한 정보(세션 상태, 클라이언트 상태, 세션 데이터 등)를 저장해 놓고 세션 쿠키( 고유한 세션 ID 값 )를 클라이언트에게 주어 서버가 클라이언트를 식별할 수 있도록 하는 방식자체를 의미하는 경우가 많다.


세션의 특징


  • 따로 용량의 제한이 없다. ( 서버의 능력에 따라 다를 수 있다. )

  • 서버에 세션 객체를 생성하며 각 클라이언트 마다 고유한 세션 ID 값을 부여한다.

  • 쿠키를 사용하여 세션 ID 값을 클라이언트에 보낸다.

  • 웹 브라우저가 종료되면 세션 쿠키는 삭제된다.


세션 작동방식


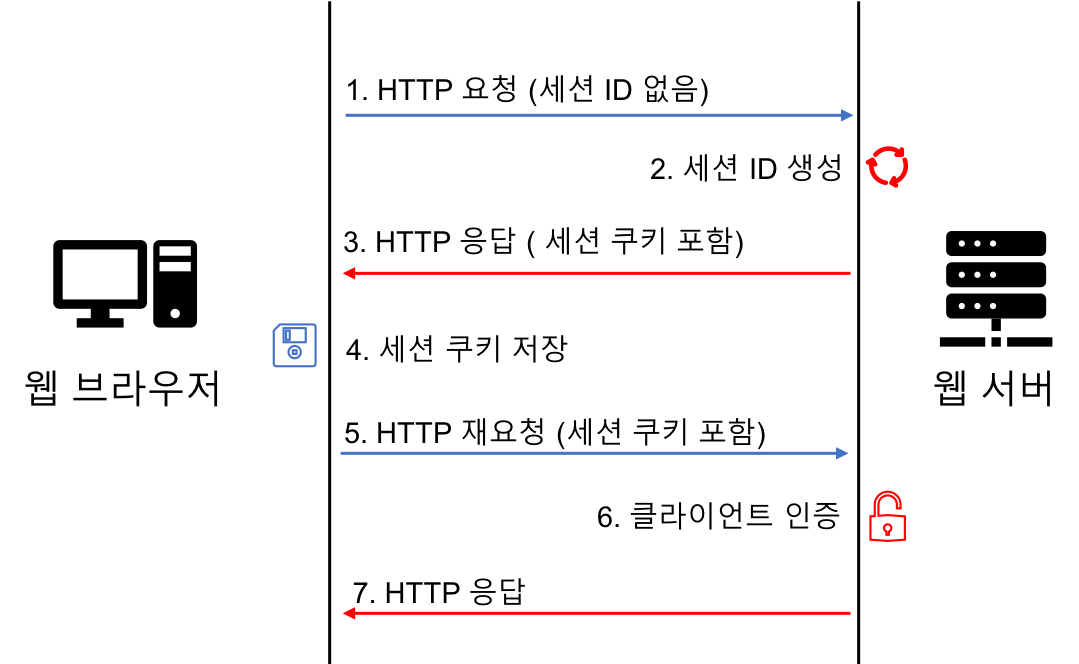
 세션의 작동방식을 보면 우선 클라이언트가 서버에 요청을 보내면 서버에서는 요청헤더( Cookie )를 확인하고 세션 ID가 있는지 확인한다. 

만약 요청에 세션 ID가 없다면 서버에서는 세션 ID를 생성한 뒤 응답을 보낼 때 쿠키에 세션 ID를 담아 보낸다. (서버에서는 이때 가장 먼저 세션 객체를 생성하여 정보를 저장한다.)

클라이언트는 응답에서 받은 세션 쿠키(세션 ID 값)를 저장해두고, 매번 해당 서버에 요청을 보낼 때마다 세션 쿠키를 함께 보내서 자신이 누구인지 인증한다. 세션 쿠키는 브라우저가 종료되면 삭제된다.


< 세션 동작 순서 >


쿠키와 세션의 관계


 흔히 쿠키와 세션을 비교할 때 쿠키는 클라이언트(웹 브라우저)에 정보를 저장하는 것이고, 세션은 서버에 정보를 저장하는 것이다 라고 비교한다. 맞는 말이지만 마치 서로 반대되는 개념처럼 오해할 수 있는데, 결국 세션은 쿠키를 이용하는 하나의 방식일 뿐이다. ( 쿠키와 세션은 방식의 차이일 뿐 반대 개념이 아니다. )

쿠키는 stateless 한 HTTP 통신에서 클라이언트에게 정보(표시)를 주어 해당 클라이언트를 식별하기 위해 만들어졌다.

클라이언트가 식별이 가능해야 서버는 특정 클라이언트와 계속해서 통신을 하고 있는지 확인이 가능하기 때문이다.

하지만 클라이언트에 저장된다는 쿠키의 특징은 보안에 있어서는 치명적인 단점이다.

예를들어 로그인을 위해 사용자가 입력한 아이디와 비밀번호를 쿠키에 담아 클라이언트에 저장한 뒤 서버에서는 쿠키로 해당 사용자가 로그인한 사용자인지 확인한다고 생각해보자. 그러면 누군가 마음만 먹으면 쿠키를 확인해 클라이언트에 저장된 아이디와 비밀번호를 볼 수 있다.

그래서 세션이라는 개념을 통해 중요한 정보는 서버에서 관리하고 클라이언트에게는 세션 쿠키( 세션 ID )를 주어 식별이 가능하도록 한 것이다. 

결론적으로 사전적 정의로 보면 세션( 통신을 시작하고 마칠 때 까지의 기간)을 유지하기 위해 쿠키를 사용하는 것인데, 용어 상으로는 세션이란 서버에 정보를 저장하고 세션 쿠키를 통해 클라이언트를 식별하는 방식을 통틀어 말하는 것으로 보면 되겠다.


쿠키와 세션 정리


 쿠키와 세션도 결국 목적( 클라이언트에서 관리하느냐, 서버에서 관리하느냐 )에 맞게 사용하면 되겠다.

(.. 클라이언트는 믿을 수 없다. 중요한 정보나 처리는 서버에서 다뤄야한다! 만 명심하자.)

예를들어 쿠키는 쇼핑몰의 장바구니, 개인 설정(팝업창 표시여부 등) 같은 것들에 많이 사용되고 세션은 로그인 유지 등에 많이 사용된다. 


반응형

'IT 정보 로그캣 > CS' 카테고리의 다른 글

정규 표현식  (0) 2020.02.03
[네트워크] 네트워크 기초 지식 정리  (0) 2019.09.03
[네트워크] get 과 post 의 차이  (2) 2019.06.03
[네트워크] http 란  (0) 2019.06.01
[알고리즘] 재귀함수  (0) 2019.04.13
반응형

 개인 혹은 기업의 필요에 따라 데이터베이스 모델을 선택하여 사용하는데 아직까지는 관계형 데이터베이스가 주류를 이룬다. 데이터베이스에서 간단하게 설명을 했지만 자주 사용하는 것인 만큼 자세히 알아둘 필요가 있다.


2019/06/07 - [IT 정보 로그캣/데이터베이스] - [데이터 베이스] 데이터베이스란 ?


[데이터 베이스] 데이터베이스란 ?

우리는 자료와 정보라는 말을 많이 사용한다. 보통 두 단어를 혼동해서 많이 사용하는데 엄밀히 따지자면 각각 정의가 다르다. 자료(Data) 는 숫자, 영상, 단어 등의 형태로 된 의미 단위로 날것(raw)에 가깝다...

noahlogs.tistory.com


관계형 데이터베이스( Relational DataBase )란


 관계형 데이터베이스는 1970년대에 IBM에서 일하던 에드거 F. 커드가 제안한 데이터베이스 모델이다.

관계형 데이터 베이스는 데이터를 테이블 형태로 저장한다.

쉽게 생각하면 엑셀 표에 데이터를 저장하는 것과 동일하다고 보면된다.

실제로 각 데이터 항목들은 행(row)에 저장되고, 항목의 속성은 열(column)이라고 표현한다. 열은 항목의 속성인 만큼 입력되는 데이터의 유형이 정해진다.


용어 정리
* 열(column) : 필드(field) 라고도 부르며, 항목의 속성(명칭)을 나타낸다.  필드 마다 각각 정수, 텍스트 같은 데이터 유형을 정할 수 있다. 

* 행(row) : 레코드(record) 라고도 부르며, 각 데이터 항목을 저장한다. 

* 스키마(schema) : 필드는 데이터 유형뿐만 아니라 제약사항도 지정할 수 있는데 이러한 제약사항을 스키마라고 부른다. 예를들어 필드는 중복 값을 해당 행에 저장할 수 없다거나, 반드시 값을 가져야 한다(not null)는 조건 등을 걸 수 있다.


관계형 데이터베이스에서의 관계


 관계형 데이터베이스는 왜 관계라는 이름이 붙여졌을까?

결론부터 말하자면 각 테이블의 행과 행이 연결되는 관계를 맺을 수 있기 때문이다. 

테이블 간의 관계는 일 대 일(1:1), 일 대 다(1:N), 다 대 다(N:N) 의 관계가 있다.

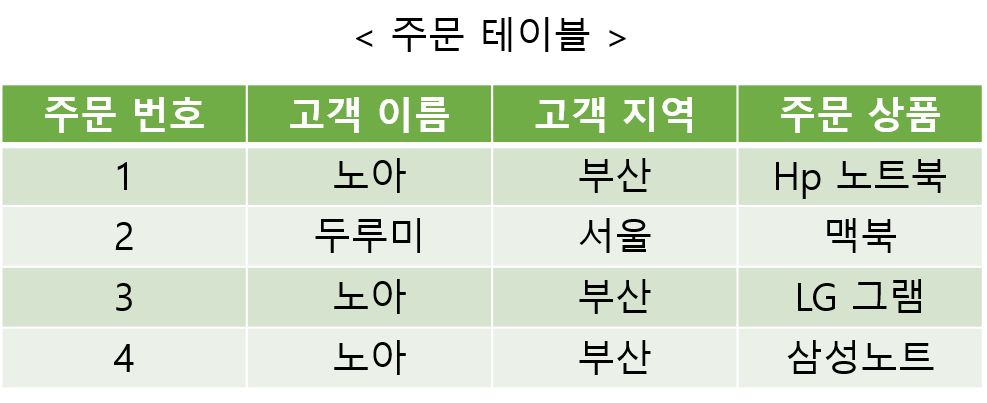
우리는 하나의 테이블에 필요한 모든 필드를 넣고 모든 데이터 항목을 저장할 수 있다. 하지만 이렇게하면 데이터들이 중복해서 저장되는 상황이 발생할 수 있어 다음 그림 테이블과 같이 비효율적이다. 


< 하나의 테이블에 모든 데이터를 넣는 경우 >

그림과 같이 고객의 상품 주문을 저장하는 테이블이 있다고 가정하면 특정 고객이 여러 상품을 구매하는 경우 고객 이름과 고객 지역 데이터가 계속 해서 중복된다. 얼핏보기에는 별 문제 없어보이지만 만약에 고객의 지역이 변경된다고 생각해보자.

그림은 데이터가 3개 뿐이지만 만약 수십, 수백만 그 이상의 데이터라면 쉬운일이 아니다.

그래서 관계형 데이터베이스 모델에서는 다음 그림과 같이 테이블을 분리하여 행과 행을 연결할 수 있다.


< 테이블을 분리시키고 각 테이블 간 행과 행 사이에 관계를 형성하는 경우 >

그림과 같이 테이블 간의 관계는 기본 키(primary key) 와 외래 키(foreign key) 라는 개념을 사용하여 맺어질 수 있다.

기본 키는 고유한 ID 필드로 그림에서는 고객 번호 필드이다. 이 필드는 각 행이 중복된 값을 가질 수 없다.

외래 키는 기본 키를 참조하는 필드로 그림에서는 주문 테이블의 고객 번호 필드이고 각 테이블의 행을 연결시켜주는 역할을 한다.

이렇게 테이블을 분리하고 관계를 형성해 데이터를 효율적으로 관리할 수 있다.

( 테이블을 분리하고 중복 데이터를 제거하는 과정을 정규화 라고 한다.)


SQL(Structured Query Language) 이란 


 관계형 데이터베이스에서 주요한 특징 중 하나는 SQL이라는 구조화 질의어를 사용한다는 것이다. SQL은 RDBMS에서 사용하는 프로그래밍 언어라고 보면 된다. SQL을 통해 RDBMS에서 데이터를 검색하고, 추가하고, 업데이트하고, 삭제하는 작업 등 데이터를 관리한다.

SQL의 종류로는 데이터 정의 언어, 데이터 조작 언어, 데이터 제어 언어 가 있는데 결국 RDBMS를 다루려면 모두 알아야하기 때문에 종류가 나뉘어 진다라는 정도만 알면 될 것 같다.


트랜잭션(transaction)이란


 트랜잭션은 데이터베이스 관리시스템(DBMS)에서 하나의 작업의 단위이다.

데이터베이스는 여러 사람들이 데이터를 공유하고 사용할 목적으로 사용된다. 그렇기 때문에 다수의 사람들이 동시에 사용하더라도 데이터에 문제가 없어야한다. 트랜잭션은 모든 명령문을 완벽하게 처리하거나, 하나의 명령문이라도 문제가 발생하면 모든 명령문을 수행하지 않고 데이터를 보존하는 기능을 하고 해야한다.

트랜잭션의 예시에 가장 적합한게 은행이라고 볼 수 있다. 예를들어 A계좌에 1000원이 있다고 하자. 이때 서로 다른 2대의 ATM 기기에서 동시에 A계좌의 1000원을 인출하려고 한다. 정말 거의 동시에 인출을 시도했을 때 트랜잭션이 제대로 기능하지 않아 두명 다 각각 1000원씩 인출해 간다면 은행은 아마 파산할 것이다. 그래서 은행은 두 트랜잭션을 모두 수행하지 않거나, 0.000001 초라도 빠른 사람의 요청을 수행하고 나머지 사람에게는 지급부족으로 요청을 거절해야 한다.

이러한 트랜잭션의 기능을 제대로 수행하기 위해서는 네 가지 특성을 만족해야하는데 ACID 특성이라고 부른다.


  • 원자성 (Atomicity) : 원자성이란 트랜잭션이 수행하는 연산들을 모두 정상적으로 처리하거나 모두 처리하지 않아야 한다는 all-or-nothing 방식을 의미한다. 

  • 일관성 (Consistency) : 일관성은 트랜잭션이 성공적으로 수행된 이후에도 데이터베이스의 데이터는 일관된 상태를 유지해야 한다는 의미이다.

  • 격리성 (Isolation) : 격리성은 하나의 트랜잭션이 완료될 때까지 다른 트랜잭션이 간섭하지 못하도록 하여 각각의 트랜잭션이 독립적으로 수행되어야 한다는 의미이다.

  • 지속성 (Durability) : 지속성은 트랜잭션이 성공적으로 완료된 이후에 데이터베이스의 데이터들이 영구적으로 보존되어야 한다는 의미이다. 


반응형
반응형

 우리는 자료와 정보라는 말을 많이 사용한다. 보통 두 단어를 혼동해서 많이 사용하는데  엄밀히 따지자면 각각 정의가 다르다.

자료(Data) 는 숫자, 영상, 단어 등의 형태로 된 의미 단위로 날것(raw)에 가깝다. 이러한 자료에 의미를 부여하거나 정리하면 정보가 된다.  

실제로 크게 구분하진 않지만 알아두면 좋을 것 같다!


데이터베이스 (DB, database )란


 데이터베이스란 여러 사람들이 공유하고 사용할 목적으로 통합 관리되는 데이터들의 모임이다.

등산할 때 기반이 되는 기지를 베이스캠프라 하듯이 데이터베이스라는 용어도 1950년대 미국에서 데이터의 기지라는 뜻에서 데이터베이스라는 용어를 처음 사용했다고 한다. 

(..데이터를 모아둔 창고라고 생각하면 되겠다.)


데이터베이스 관리 시스템 (DBMS, DataBaseManagementSystem)


 데이터베이스 관리 시스템이란 다수의 사용자들이 데이터베이스 내의 데이터를 접근할 수 있도록 해주는 소프트웨어들을 의미한다.

데이터베이스 관리 시스템이 존재하기 이전에는 파일 시스템을 이용하여 데이터를 관리하였다.

파일 시스템은 응용 프로그램을 이용해 데이터를 파일로 관리하는 것이다.

예를들어 쇼핑몰의 경우 고객관리 프로그램과 주문관리 프로그램이 존재하여 각각 데이터를 파일로 저장해 관리한다.

파일을 기반으로 데이터를 관리하게되면 데이터 중복, 데이터 불일치 등 문제가 발생한다.

이러한 파일 시스템의 단점을 보완하기 위해 데이터베이스가 생겨났다.

데이터베이스는 곧 데이터베이스 관리 시스템이라 할만큼 데이터베이스 관리 시스템은 중요하다고 볼 수 있다.

데이터베이스 관리 시스템을 전문적으로 운영하는 인력을 DBA (DataBase Administrator)라 한다.


데이터 불일치 문제란?
데이터 불일치 문제는 데이터를 파일로 저장했을 때 파일을 수정하는 도중에 해당 파일을 불러온다면 데이터가 동기화 문제가 발생하여 데이터가 불일치하는 문제가 발생할 수 있다.


데이터베이스 관리 시스템의 특징


데이터베이스 관리 시스템은 파일 시스템의 문제점을 해결하기 위해 만들어졌기 때문에 

데이터베이스 관리 시스템의 특징은 곧 파일 시스템의 단점을 의미한다.


1. 데이터의 독립성 ( 파일 시스템은 데이터와 응용 프로그램이 상호 의존 관계에 있다. )

  • 물리적 독립성 : 데이터베이스 사이즈를 늘리거나 성능 향상을 위해 데이터 파일을 늘리거나 새롭게 추가하더라도 관련된 응용 프로그램을 수정할 필요가 없다.
    (파일 시스템은 응용 프로그램의 기능을 확장하려면 파일의 구조를 재조직해야 한다.)

  • 논리적 독립성 : 데이터베이스는 다양한 응용 프로그램의 논리적 요구를 만족시켜줄 수 있다.
    ( 파일 시스템에서는 파일의 구조가 응용 프로그램에 반영되어 있기 때문에 파일의 구조가 바뀌면 영향을 받는 모든 응용 프로그램들을 수정해야 한다. )


2. 데이터의 무결성 

 : 여러 경로를 통해 잘못된 데이터가 발생하는 경우의 수를 방지하는 기능으로 데이터의 유효성 검사를 통해 데이터의 무결성을 구현하게 된다. 예를들면 입력 조건에 맞지 않는 입력값은 저장할 수 없도록 방지하는 기능이 있을 수 있다.

( 파일 시스템은 응용 프로그램 별로 제약 조건을 하나하나 처리해야하기 때문에 무결성을 유지하기가 어렵다. )


3. 데이터의 보안성 

 :  허가된 사용자들만 데이터베이스나 데이터베이스 내의 자원에 접근할 수 있도록 계정 관리 또는 접근 권한을 설정함으로써 모든 데이터에 보안을 구현할 수 있다.

( 파일 시스템은 파일 단위로 검색, 갱신, 실행 등의 권한을 부여할 수 있어서 사용자 별 세밀한 접근 제어가 어렵다.)


4. 데이터의 일관성 

 : 연관된 정보를 논리적인 구조로 관리함으로써 어떤 하나의 데이터만 변경했을 경우 발생할 수 있는 데이터의 불일치성을 배제할 수 있다.

또한 작업 중 일부 데이터만 변경되어 나머지 데이터와 일치하지 않는 경우의 수를 배제할 수 있다.

( 파일 시스템에서는 중복된 데이터를 변경하는 게 어렵기 때문에 중복 데이터 중 일부만 변경된다고 하면 중복 데이터 간에 불일치가 발생할 수 있다. )


5. 데이터의 중복 최소화 

 : 데이터베이스는 데이터를 통합해서 관리함으로써 데이터 중복 문제를 해결할 수 있다.

( 파일 시스템은 응용 프로그램별로 데이터를 파일로 관리하기 때문에 같은 데이터가 여러 파일에 저장되어 데이터 중복 문제가 발생할 수 있다. )


데이터베이스 관리 시스템의 종류


DBMS는 시간이 지남에 따라 계속해서 새로운 모델들이 제시되어 왔다.

기존의 DBMS 모델의 문제점이나 단점을 보완하기 위해 계속해서 새로운 모델들이 만들어지기 때문이다.

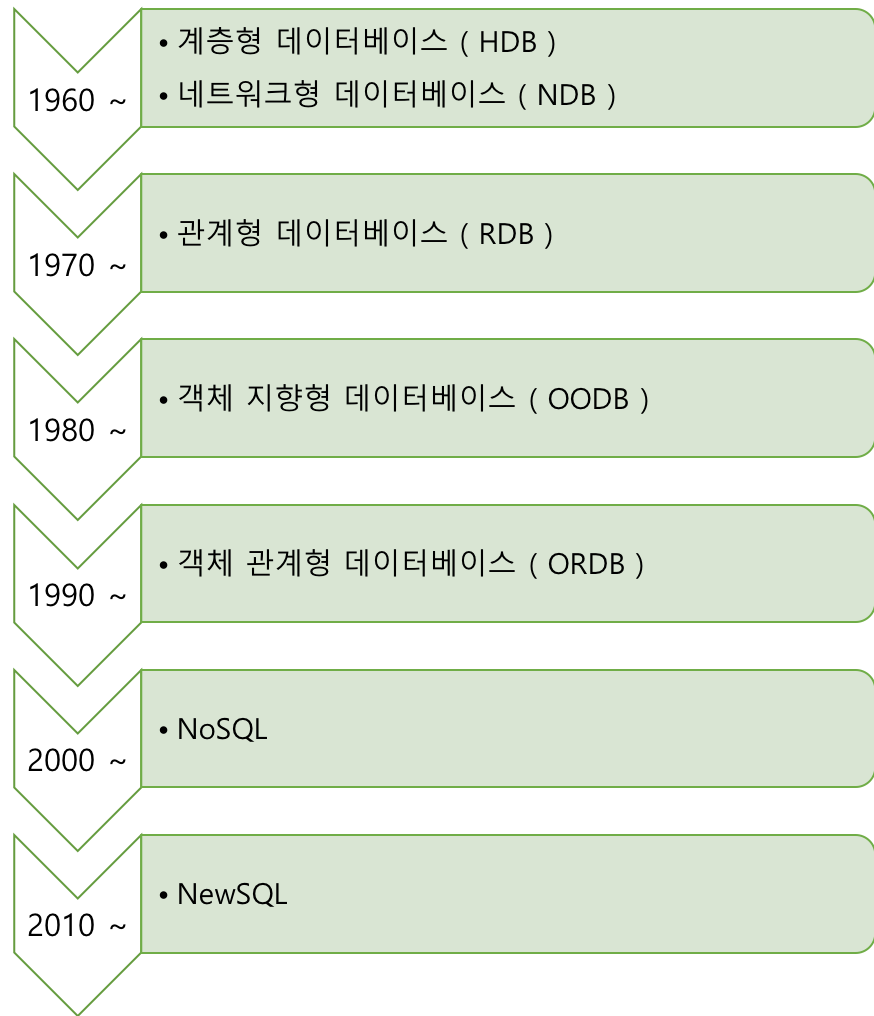
각 DBMS 모델을 간단히 정리해보면 다음과 같다.


< 데이터베이스 모델 발전 과정 >


계층형 ( Hierarchical DataBase )

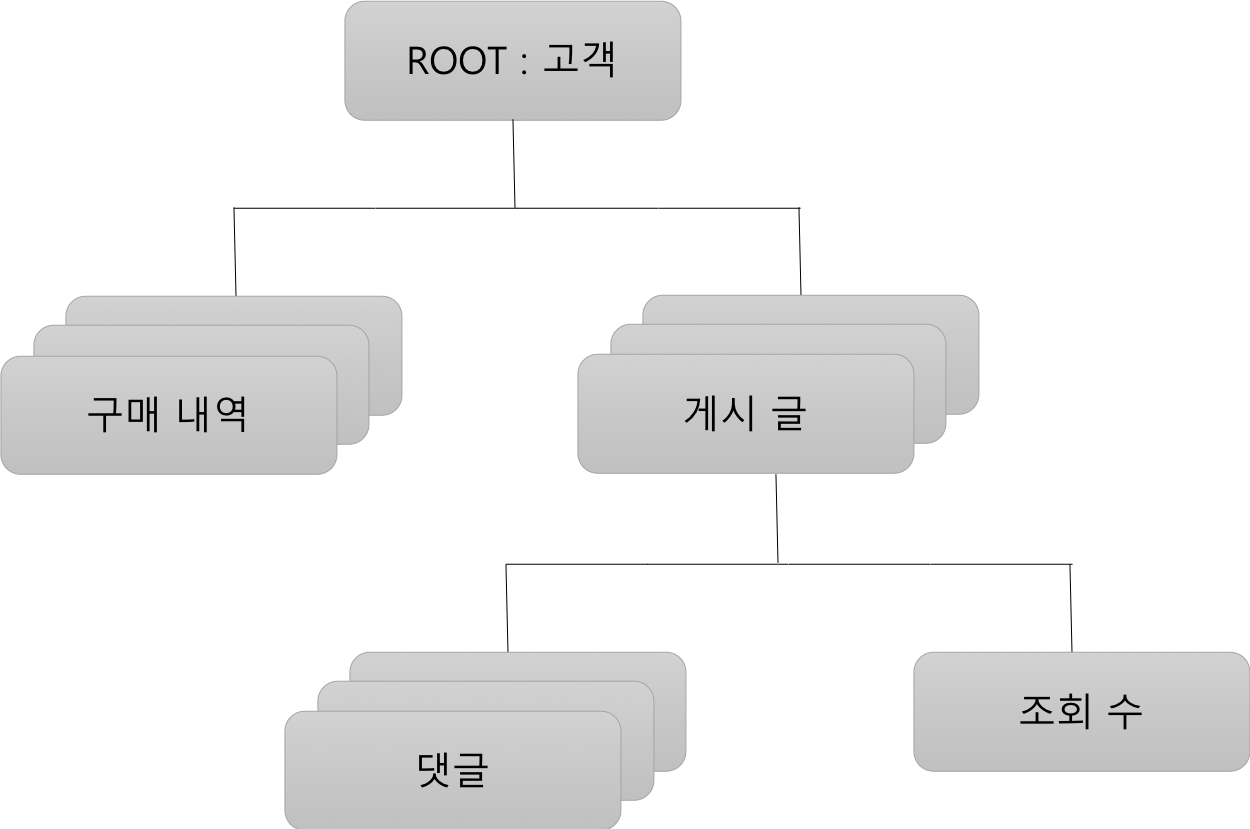
  • 데이터 간의 관계가 트리 형태의 구조이다. 트리는 부모-자식 관계로 표현되며 부모와 자식 간에는 1:N ( 일 대 다 )로 구성될 수 있다.
    데이터를 세그먼트 ( 레코드 ) 단위로 관리하며 세그먼트 간 계층을 트리구조로 관리한다. 구조가 간단하고 구현, 수정, 검색이 쉽지만 부모 자식 간에 N:N (다 대 다) 관계 처리가 불가능하고, 구조 변경이 어렵다.

  • DBMS 예 : IMS ( IBM 의 Information Management System )

< 계층형 데이터베이스 모델 구조 >


네트워크형 ( Network DataBase )

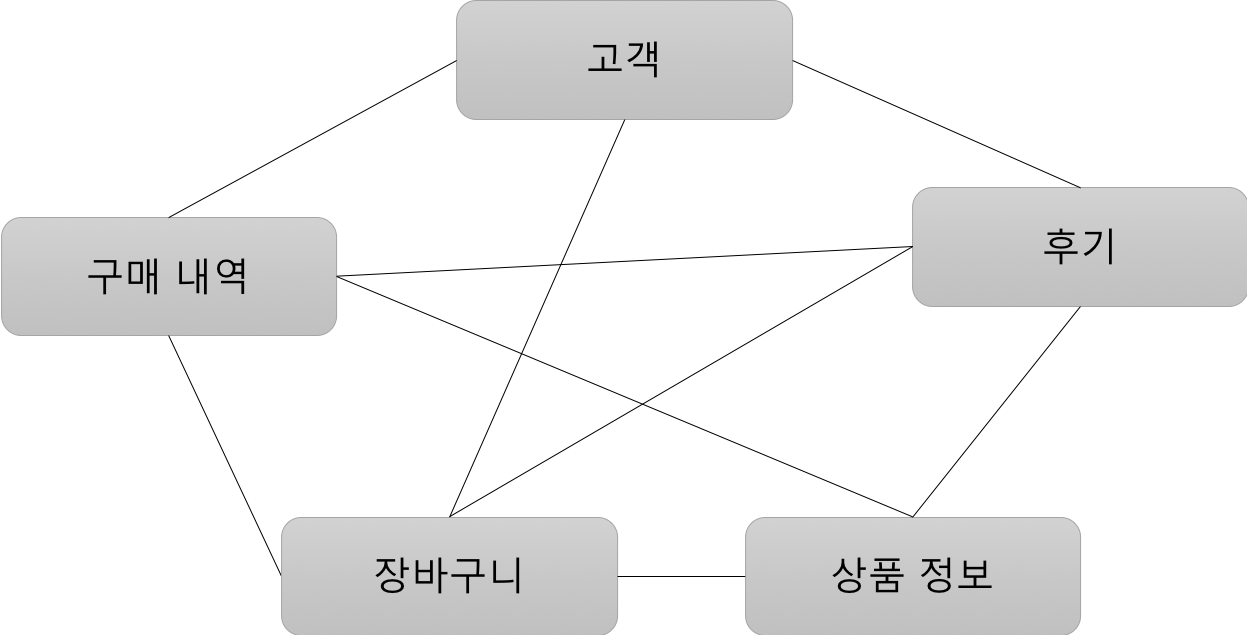
  • 계층형 데이터베이스의 단점을 보완하여 데이터 간 N:N ( 다 대 다) 구성이 가능한 망 형 모델이다. 계층 구조에 링크를 추가하여 유연성과 접근성을 높였다. 하지만 구조가 복잡해 유지보수가 어렵다.

  • DBMS 예 : IDMS ( Integrated Data Store ) 

< 네트워크형 데이터베이스 모델 구조 >


관계형 ( Relational DataBase )

  • 관계형 데이터베이스 모델은 키( key )와 값 ( value )으로 이루어진 데이터들을 행( row )과 열 ( Column )로 구성된 테이블 구조로 단순화 시킨 모델이다. SQL ( Structured Query Language ) 를 사용하여 테이터를 처리한다. 데이터 모델링이 간단하지만 CAD/CAM , GIS 등과 같은 비정형 데이터들을 다루거나 실시간 분석에는 적합하지 않다.

  • DBMS 예 : MySQL 

< 관계형 데이터베이스 모델 구조 >


객체 지향형 ( Object-Oriented DataBase )

  • 객체지향 프로그래밍 개념에 기반하여 만든 데이터베이스 모델이다. 정보를 객체의 형태로 표현한다. 객체지향 프로그래밍 개념 ( 클래스, 상속 등 )을 사용할 수 있다.
    CAD/CAM. GIS 등의 비정형 데이터들을 데이터베이스화 할 수 있도록 하기 위해 만들어진 모델이다.
    멀티미디어 데이터 지원이 가능하지만 SQL 쿼리를 사용할 수 없고 ( OQL 이 있긴하다. ), 검색이나 대규모 트랜잭션 처리에서 성능이 떨어지는 단점이 있어 몇몇 특수한 전문분야 정도에서만 사용되고 있다.

  • DBMS 예 : O2, ONTOS


객체 관계형 ( Object-Relational DataBase )

  • 관계형 데이터베이스에 객체 지향 개념을 도입하여 만든 데이터베이스 모델이다. 객체지향 개념을 지원하는 표준 SQL을 사용할 수 있고, 데이터 타입도 관계형 데이터베이스 보다 더 다양하게 추가되었다.

  • DBMS 예 : UniSQL, Object store


NoSQL 

  • Not Only SQL 의 줄임말로 SQL 뿐만 아니라 다양한 특성을 지원한다는 의미라고 해석할 수 있다. 데이터 간에 관계를 정의하지 않는 데이터베이스 모델로 기존의 RDBMS 의 복잡도와 용량의 한계를 극복하기 위한 목적으로 만들어졌다. 비정형 데이터 처리에 유리하지만 스키마 변경이 불가능해  데이터값에 문제가 발생하면 감지가 어렵다. 

  • DBMS 예 : redis


NewSQL

  • New 와 SQL 의 합성어이다. RDBMS 의 SQL 과 NoSQL 의 장점을 결합하여 관계형 모델, 트랜잭션 지원 및 확장성과 고 가용성을 모두 만족시키려는 목적에서 만들어진 데이터베이스 모델이다.

  • DBMS 예 : VoltDB


반응형
반응형

GET 과 POST 는 HTTP 메서드로 클라이언트에서 서버로 무언가를 요청할 때 사용한다. 


2019/06/01 - [IT 정보 로그캣/CS] - [네트워크] http 란


[네트워크] http 란

기본적으로 네트워크 통신을 할 때 처음 접하는게 http 통신이다. 개발자가 아니더라도 http는 많이 듣는 용어일 정도로 우리가 많이 접하고 있고, 중요하다. 내가 사용하는 기술이 최소한 어떤 건지, 왜 사용하는..

noahlogs.tistory.com

과거에  5년차 이상 서버 개발자와 일한 경험이 있는데, 로그인 API를 요청했는데 GET 과 POST 둘 다 요청이 가능하도록 만들어 주는 것이었다... 암호화를 한것도 아니라서 POST도 완벽한 보안이 되는건 아니지만 정말 최소한의 보안 의식도 없는건가 아니면 구분을 못해서 그런건가 싶었다. 이렇듯 HTTP 통신을 제대로 사용하기 위해서도 둘의 차이를 아는 게 중요하다.


GET 이란?


 GET 은 클라이언트에서 서버로 어떠한 리소스로 부터 정보를 요청하기 위해 사용되는 메서드이다. 

예를들면 게시판의 게시물을 조회할 때 쓸 수 있다.

GET을 통한 요청은 URL 주소 끝에 파라미터로 포함되어 전송되며, 이 부분을 쿼리 스트링 (query string) 이라고 부른다.

방식은 URL 끝에 " ? " 를 붙이고 그다음 변수명1=값1&변수명2=값2... 형식으로 이어 붙이면 된다.

예를들어 다음과 같은 방식이다. 

www.example.com/show?name1=value1&name2=value2

서버에서는 name1 과 name2 라는 파라미터 명으로 각각 value1 과 value2 의 파라미터 값을 전달 받을 수 있다.


GET의 특징


  • GET 요청은 캐시가 가능하다. 

     : GET을 통해 서버에 리소스를 요청할 때 웹 캐시가 요청을 가로채 서버로부터 리소스를 다시 다운로드하는 대신 리소스의 복사본을 반환한다. HTTP 헤더에서 cache-control 헤더를 통해 캐시 옵션을 지정할 수 있다.

  • GET 요청은 브라우저 히스토리에 남는다.

  • GET 요청은 북마크 될 수 있다.

  • GET 요청은 길이 제한이 있다.

     : GET 요청의 길이 제한은 표준이 따로 있는건 아니고 브라우저마다 제한이 다르다고 한다. 

  • GET 요청은 중요한 정보를 다루면 안된다. ( 보안 )

     : GET 요청은 파라미터에 다 노출되어 버리기 때문에 최소한의 보안 의식이라 생각하자.

  • GET은 데이터를 요청할때만 사용 된다.


POST 란?


 POST는 클라이언트에서 서버로 리소스를 생성하거나 업데이트하기 위해 데이터를 보낼 때 사용 되는 메서드다. 예를들면 게시판에 게시글을 작성하는 작업 등을 할 때 사용할 된다.

POST는 전송할 데이터를 HTTP 메시지 body 부분에 담아서 서버로 보낸다. ( body 의 타입은 Content-Type 헤더에 따라 결정 된다.)

GET에서 URL 의 파라미터로 보냈던 name1=value1&name2=value2 가 body에 담겨 보내진다 생각하면 된다.

POST 로 데이터를 전송할 때 길이 제한이 따로 없어 용량이 큰 데이터를 보낼 때 사용하거나 GET처럼 데이터가 외부적으로 드러나는건 아니라서 보안이 필요한 부분에 많이 사용된다. 

( 하지만 데이터를 암호화하지 않으면 body의 데이터도 결국 볼 수 있는건 똑같다. )

POST를 통한 데이터 전송은 보통 HTML form 을 통해 서버로 전송된다. 


POST의 특징


  • POST 요청은 캐시되지 않는다.

  • POST 요청은 브라우저 히스토리에 남지 않는다.

  • POST 요청은 북마크 되지 않는다.

  • POST 요청은 데이터 길이에 제한이 없다.


GET 과 POST 의 차이점 


 GET과 POST의 특징만 보아도 차이가 나긴하지만 추가적으로 차이점을 정리해보면 다음과 같다.


  • 사용목적 : GET은 서버의 리소스에서 데이터를 요청할 때, POST는 서버의 리소스를 새로 생성하거나 업데이트할 때 사용한다.

    DB로 따지면 GET은 SELECT 에 가깝고, POST는 Create 에 가깝다고 보면 된다.

  • 요청에 body 유무 : GET 은 URL 파라미터에 요청하는 데이터를 담아 보내기 때문에 HTTP 메시지에 body가 없다. POST 는 body 에 데이터를 담아 보내기 때문에 당연히 HTTP 메시지에 body가 존재한다.

  • 멱등성 (idempotent) : GET 요청은 멱등이며, POST는 멱등이 아니다.

멱등이란?

멱등의 사전적 정의는 연산을 여러 번 적용하더라도 결과가 달라지지 않는 성질을 의미한다.

GET은 리소스를 조회한다는 점에서 여러 번 요청하더라도 응답이 똑같을 것 이다. 반대로 POST는 리소스를 새로 생성하거나 업데이트할 때 사용되기 때문에 멱등이 아니라고 볼 수 있다. (POST 요청이 발생하면 서버가 변경될 수 있다.)


GET과 POST는 이런 차이들이 있기 때문에 사용하려는 목적에 맞는 확인한 후에 사용해야한다.

GET과 POST 이외에도 PUT , DELETE 등을 적절히 사용하는게 좋은데 예를들어 봇의 경우에 사이트를 돌아다니면서 GET 요청을 날린다. 이럴 때 DELETE 등을 GET으로 처리하면 봇에 의해 서버에 있는 리소스들이 삭제 되는 상황이 일어 날수 있다! 항상 기술을 사용할 때 왜 를 잊지말자.


반응형

+ Recent posts